手里有一张 RX 7900 XTX(24 GiB / gfx1100 / RDNA3)。它能跑多大的模型、该用哪种量化、并发开到几才划算——这些问题最后都会收束到同一个量上:算存比(arithmetic intensity, AI)。
这篇文章把一天半里在 7900 XTX 上做的一批推理实验串成一根线:llama.cpp 与 vLLM 两套引擎、FP32 / FP16 / BF16 / INT8 / INT4 / FP8 六种精度、0.5B / 4B / 7B 三种模型尺寸、并发 N=1→16 的扫描,全部对着理论 roofline 校准。
一句话结论:这张卡在 7B 量级上,单请求 decode 能跑到实测 HBM 读带宽的约 91%;但即使是 N=16 的并发,离算力受限区仍然差 2~8 倍(取决于用 HBM 还是 IF 口径算 ridge)。 以及两个反直觉的点——算存比本身并不随模型变大而升高,变的是带宽利用率;还有 96 MiB Infinity Cache 让这张卡的带宽屋顶实际上有两档,笼统地按 960 GB/s 算会系统性低估小算子。
一、先把”算存比”这件事说清楚
算存比(算术强度)的定义很朴素:
1 | AI = 一次推理里发生的运算数 / 为完成这些运算从显存搬进来的字节数 [OP/Byte] |
Roofline 模型把这张卡的性能上限写成两条线的下包络:
1 | 性能 = min( 峰值算力 , 带宽 × AI ) |
于是每条 roofline 都有一个拐点——ridge point:
1 | AI_ridge = 峰值算力 / 带宽 |
- 当
AI < AI_ridge:带宽受限,性能 ≈ 带宽 × AI,堆算力没用; - 当
AI > AI_ridge:算力受限,性能 ≈ 峰值算力,堆带宽没用。
RX 7900 XTX(RDNA3,48 CU)的官方口径:
| 精度 | 峰值 | 说明 |
|---|---|---|
| FP32 | 61.4 TFLOPS | vector |
| FP16 / BF16 | 123 TFLOPS | matrix |
| INT8 | 123 TOPS | matrix |
| INT4 | 246 TOPS | matrix |
| FP8 | — | RDNA3 无原生 FP8 WMMA,不设峰值 |
| HBM 带宽 | 960 GB/s | 24 GB GDDR6 |
代入 AI_ridge = 峰值 / 960 GB/s:
| 精度 | ridge point (OP/Byte) |
|---|---|
| FP32 | 63.96 |
| FP16 / BF16 / INT8 | 128.125 |
| INT4 | 256.25 |
所以任何一次推理,只要算存比落在个位数,就必然是带宽受限。后面所有实测都会反复撞到这条结论。
二、三层口径:别把”等效带宽”当成”实测 DRAM”
做这类实验最容易翻车的地方,是把不同来源的数字混在一起。本文严格区分三层:
- 逻辑权重 AI:只计”把权重读一遍 + 每个参数 2 FLOP 的乘加”。不含 KV cache、激活、attention、反量化、采样。
- 等效权重读带宽:
decode tok/s × 每 token 权重字节。这是一个由吞吐反推的等效量,不是硬件计数器读数。 - profiler DRAM counter:真正读
rocprof/uprof的显存流量计数器。
本次实验没有采集第 3 层,所以本文里出现的”有效带宽””等效带宽”全部属于第 2 层,请勿与硬件计数器混淆。之所以用这套口径,是因为它能在同一把尺子下横向比较不同引擎、不同精度、不同尺寸,而不受各引擎 profiler 支持度差异的干扰。
三、实验平台与方法
硬件:AMD Radeon RX 7900 XTX,24 GiB,gfx1100,48 CU,96 MiB Infinity Cache。
引擎:
- llama.cpp:
/opt/llamacpp的 gfx1100 ROCm 构建,跑 GGUF; - vLLM:Docker 镜像,PyTorch 2.12 + ROCm 10 + HIP,跑 HF 权重。
模型(覆盖三个量级;4B 一档用的是 Qwen3-4B,与另外两档并非同一代,仅作尺寸对照):
| 模型 | hidden | inter | layers | vocab | Q/KV heads | head_dim | tied |
|---|---|---|---|---|---|---|---|
| Qwen2.5-0.5B-Instruct | 896 | 4864 | 24 | 151936 | 14 / 2 | 64 | 是 |
| Qwen3-4B | 2560 | 9728 | 36 | 151936 | 32 / 8 | 128 | 是 |
| Qwen2.5-7B-Instruct | 3584 | 18944 | 28 | 152064 | 28 / 4 | 128 | 否 |
精度:
- llama.cpp:FP32 / FP16 / BF16 / Q8_0 / Q4_K_M(GGUF);
- vLLM:FP16 / BF16 / FP32 / FP8-dynamic / INT4(GPTQ、AWQ) / INT8(GPTQ)。
workload:input_len=512、output_len=128,5 次测量 + 2 次 warmup;并发用 vllm bench latency --batch-size N,N = 1/2/4/8/16。
HBM microbenchmark:read_sum / write_zero / copy / triad_add 四种访存模式,256 / 512 / 1024 MiB,各 30 次,取中位数。
Infinity Cache(IF Cache)扫描:这块卡有 96 MiB Infinity Cache,在 ROCm 计数器里就是 GL2C 这一级。为了把它从”总带宽”里切出来,做了两组补充实验:
- 工作集扫描:同一组访存原语(
read_sum/write_zero/copy/triad_add),工作集从 8 MiB 扫到 1 GiB,每档 25 个样本取中位数,样本内部循环若干次以摊平 kernel 启动开销。目的:找出 96 MiB 两侧的带宽断点。 - 真实 kernel 权重扫描:用 llama.cpp 自带的
test-backend-ops perf跑模型实际使用的 ROCmMUL_MATkernel,固定m = 4096(输出行数固定 ⇒ 并行度恒定),n = 1(decode)与n = 16,扫k使权重体量|W| = m·k·bpe从 8 MiB 走到 512 MiB,在 96 MiB 前后各取足够密的点。类型f16 / q8_0 / q4_K / f32。
补充实验的完整数据、脚本与图在
experiments/ifcache_arith_7900xtx_20260924/。
四、先量一把这张卡的带宽
所有推理的上限都建立在这张卡真实的访存能力上。1 GiB 工作集下的中位数:
| 访存模式 | 有效带宽 (GB/s) |
|---|---|
| read_sum(纯读) | 874.2 |
| write_zero(纯写) | 933.4 |
| copy(读+写) | 778.4 |
| triad_add(2 读 + 1 写) | 801.3 |
也就是说,官方标称的 960 GB/s,实际纯读大约能摸到 874 GB/s(91%),混合读写会掉到 780~800 GB/s。
但这张卡不止一个带宽档位。 上面测的是”数据远大于缓存”时的情况。7900 XTX 还有 96 MiB Infinity Cache,当工作集装得进这 96 MiB 时,服务它的是 L2 而不是 GDDR6:
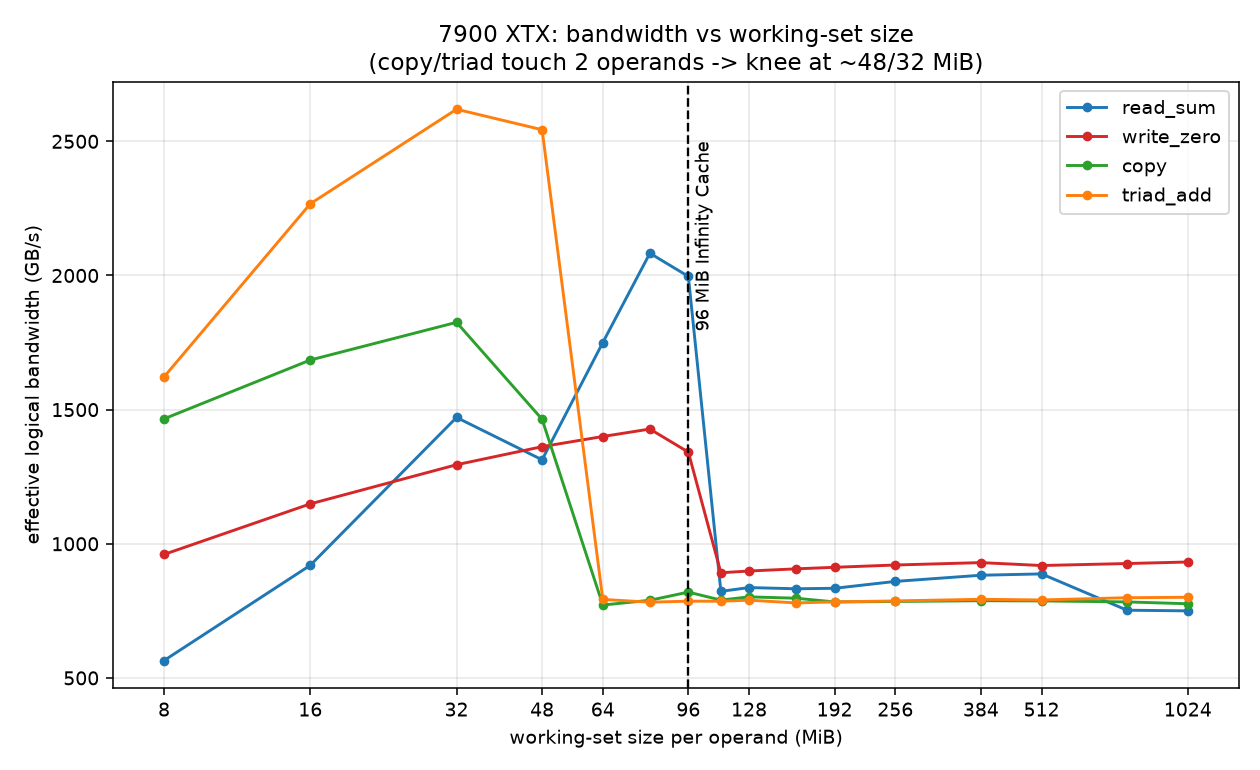
| 每次操作数据 (MiB) | read_sum | write_zero | copy | triad_add |
|---|---|---|---|---|
| 8 | 565 | 960 | 1466 | 1622 |
| 16 | 920 | 1149 | 1685 | 2267 |
| 32 | 1471 | 1295 | 1825 | 2620 |
| 48 | 1313 | 1362 | 1464 | 2543 |
| 64 | 1750 | 1400 | 772 | 793 |
| 80 | 2083 | 1428 | 789 | 782 |
| 96 | 1997 | 1342 | 820 | 786 |
| 112 | 823 | 892 | 790 | 786 |
| 128 | 837 | 899 | 802 | 790 |
| 256 | 860 | 921 | 785 | 787 |
| 512 | 888 | 919 | 787 | 791 |
| 1024 | 750 | 932 | 776 | 801 |
(单位 GB/s)
三个要点:
- 断点是硬的,不是渐变。 纯读在 80 MiB = 2083 GB/s、96 MiB = 1997 GB/s,到 112 MiB 直接掉到 823 GB/s——一步 2.4 倍阶跃。96→112 MiB 正好卡在 IF Cache 容量上。
copy/triad的断点提前到 ~48/32 MiB,因为它们同时占用两份数据(footprint = 2 × 数组大小)。triad在 32 MiB 达到 2620 GB/s,是 IF 读写合计能力的体现。- 大于 112 MiB 后所有曲线收敛到 0.78–0.93 TB/s,与上面 1 GiB 那一档完全一致 ⇒ 这一档才是纯 HBM。
注意:8–16 MiB 的
read_sum偏低(565/920)不是带宽不够,而是并行度不足——小数组喂不满 48 个 CU。IF 的”满血”区间要从 32 MiB 往上看。
所以这张卡的带宽屋顶是两档:工作集 ≤ 96 MiB 时是 ~2 TB/s(IF),超出后是 ~874 GB/s(HBM 实测)/ 960 GB/s(官方)。后面凡是超过 960 GB/s 的”等效带宽”,一定是在吃 IF,而不是 HBM 变快了。
五、算子级:n=1 和 n=512 是两个世界
先看最干净的一层——单个大矩阵乘(m=4096, k=14336)在不同 batch(n)下的 roofline 位置:
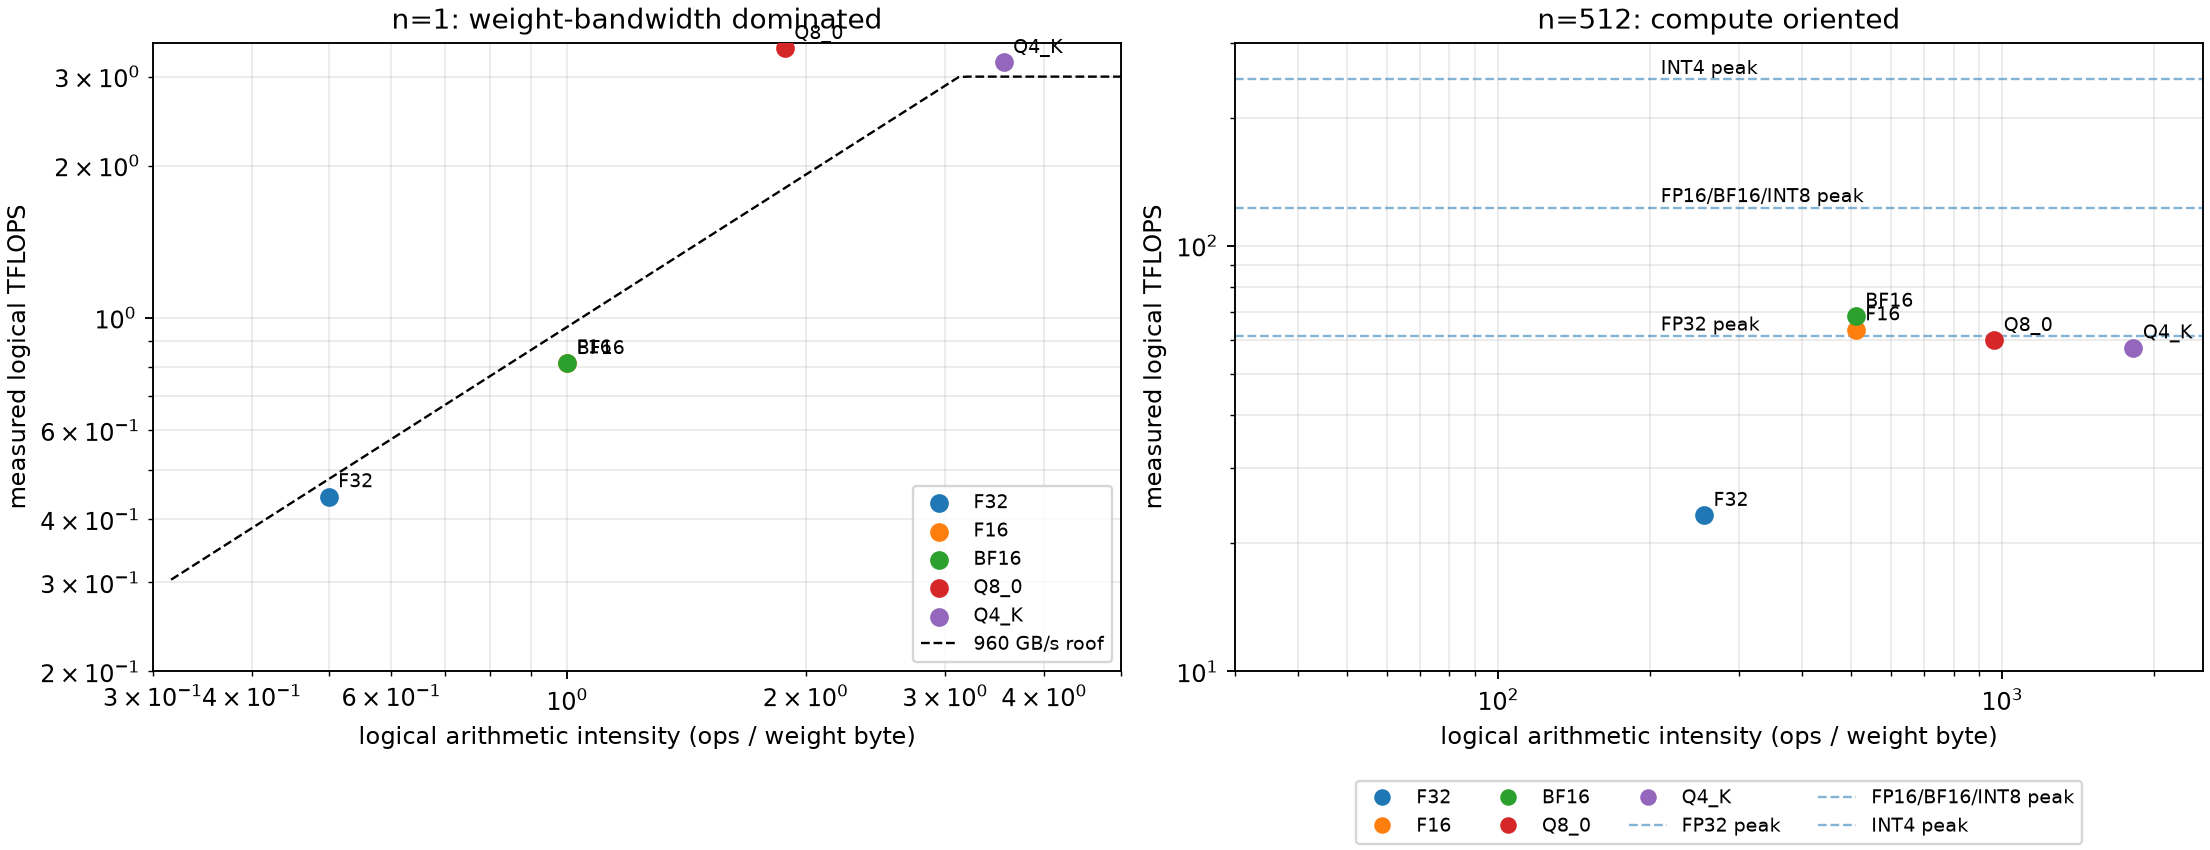
右图(n=512,接近 prefill 形状):点集体向右上迁移,落在算力屋顶附近。同一个 kernel,仅仅因为 batch 变大、权重被复用 512 次,就从带宽受限滑进了算力受限。
这一张图就解释了:为什么 prefill 快、decode 慢,为什么它们的瓶颈根本不是一个东西。
5.1 n=1 出现超过 HBM 的数字,说明这一段测的是 IF 不是 HBM
左图(n=1,decode 形状)有个不能放过的细节。n=1 时矩阵乘退化成”把权重整体读一遍、每个元素只参与一次乘加”,算存比很低,本该是纯权重带宽主导。但同一张表里出现了在纯 HBM 模型下不可能的数字:
| 类型 | 权重 | 逻辑 AI | 表观权重读带宽 | 相对 960 GB/s | 受限层 |
|---|---|---|---|---|---|
| F32 | 224.0 MiB | 0.500 | 886.3 GB/s | 92.3% | HBM |
| F16 | 112.0 MiB | 1.000 | 815.2 GB/s | 84.9% | HBM |
| BF16 | 112.0 MiB | 1.000 | 812.6 GB/s | 84.6% | HBM |
| Q8_0 | 59.5 MiB | 1.882 | 1811.0 GB/s | 188.6% | IF Cache |
| Q4_K | 31.5 MiB | 3.556 | 900.5 GB/s | 93.8% | compute / kernel |
Q8_0 的 1811 GB/s 是 HBM 标称 960 GB/s 的 1.89 倍——单靠 GDDR6 永远测不出来。 唯一解释是:这份 62 MB 的权重整体驻留进了 96 MiB Infinity Cache,服务它的是 IF 的 ~2 TB/s。F32 的 224 MiB、F16/BF16 的 112 MiB 都超过或贴着 IF 容量,所以那三个数字才真的是 HBM。而 Q4_K 的 900 GB/s 也不是”HBM 打满”,是 kernel 打不满 HBM——它的瓶颈在反量化,不在访存。
5.2 用真实 kernel 把 96 MiB 边界扫出来
光有一个点不够。我们直接用 llama.cpp 的 ROCm MUL_MAT kernel,固定并行度(m=4096),让权重体量从 8 MiB 扫到 512 MiB,跨过 96 MiB:
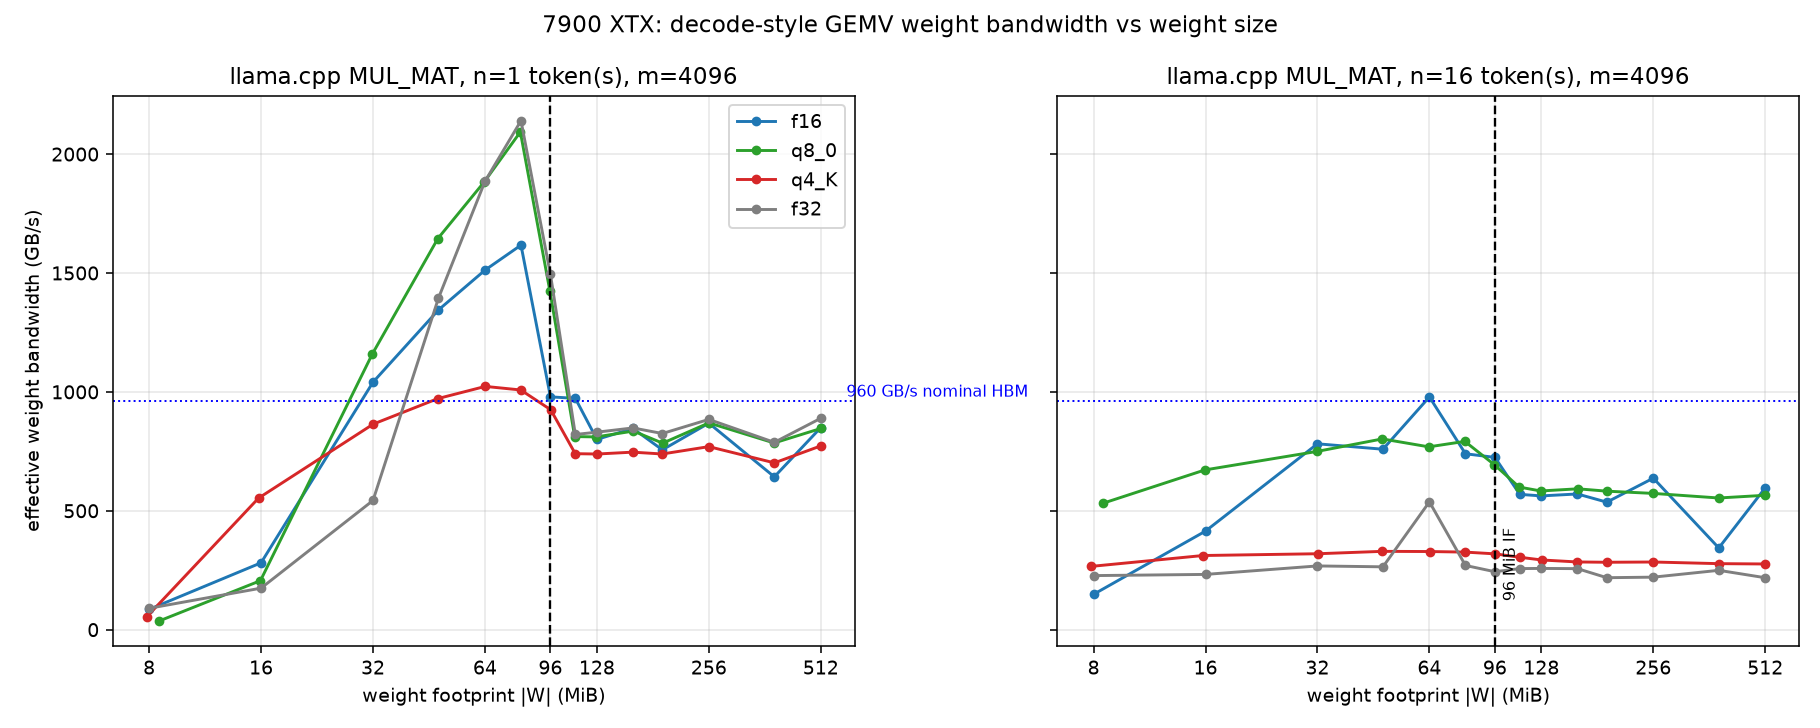
n=1(decode)的表观权重带宽(GB/s):
| 权重体量 (MiB) | f16 | q8_0 | q4_K | f32 |
|---|---|---|---|---|
| 32 | 1041 | 1160 | 865 | 543 |
| 48 | 1345 | 1645 | 972 | 1395 |
| 64 | 1512 | 1884 | 1023 | 1885 |
| 80 | 1617 | 2093 | 1008 | 2141 |
| 96 | 979 | 1426 | 925 | 1494 |
| 112 | 973 | 812 | 740 | 821 |
| 128 | 800 | 811 | 739 | 831 |
| 512 | 850 | 846 | 773 | 889 |
三个要点:
- f16 / q8_0 / f32 的峰值都落在 64–80 MiB,越过 96 MiB 后集体跌到 ~0.8 TB/s。 而且峰值(1617 / 2093 / 2141 GB/s)都远超 960 GB/s——只有 IF 能解释。
- 峰值出现在 ~80 MiB 而不是 96 MiB:权重把 96 MiB 填满后,激活、输出、量化 scale 就没地方放了,开始互相驱逐。所以 IF 的”可用容量”实际是 80–96 MiB。
- Q4_K 是例外:曲线平得多(1023 → 747),IF 内外只差 1.37×。INT4 的瓶颈是反量化与计算,访存不再是主约束,IF 帮不上忙——这正好复现了 5.1 里”Q4_K 的 900 GB/s 是 kernel 上界”那句话。
5.3 LLM 的算子到底放不放得进这 96 MiB?
把 4B / 7B 每层主干算子的单份权重和 96 MiB 对照:
| 算子 | 4B BF16 | 4B Q4_K | 7B BF16 | 7B Q4_K |
|---|---|---|---|---|
| qkv_proj | 30.0 | 8.4 | 31.5 | 8.9 |
| o_proj | 20.0 | 5.6 | 24.5 | 6.9 |
| gate_up_proj | 95.0 | 26.7 | 259.0 | 72.8 |
| down_proj | 47.5 | 13.4 | 129.5 | 36.4 |
| lm_head | 741.9 | 208.7 | 1039.5 | 292.4 |
| 单层四主干合计 | 192.5 | 54.1 | 444.5 | 125.0 |
(单位 MiB;4B 是 tied embedding,lm_head 与 embedding 共享存储。)
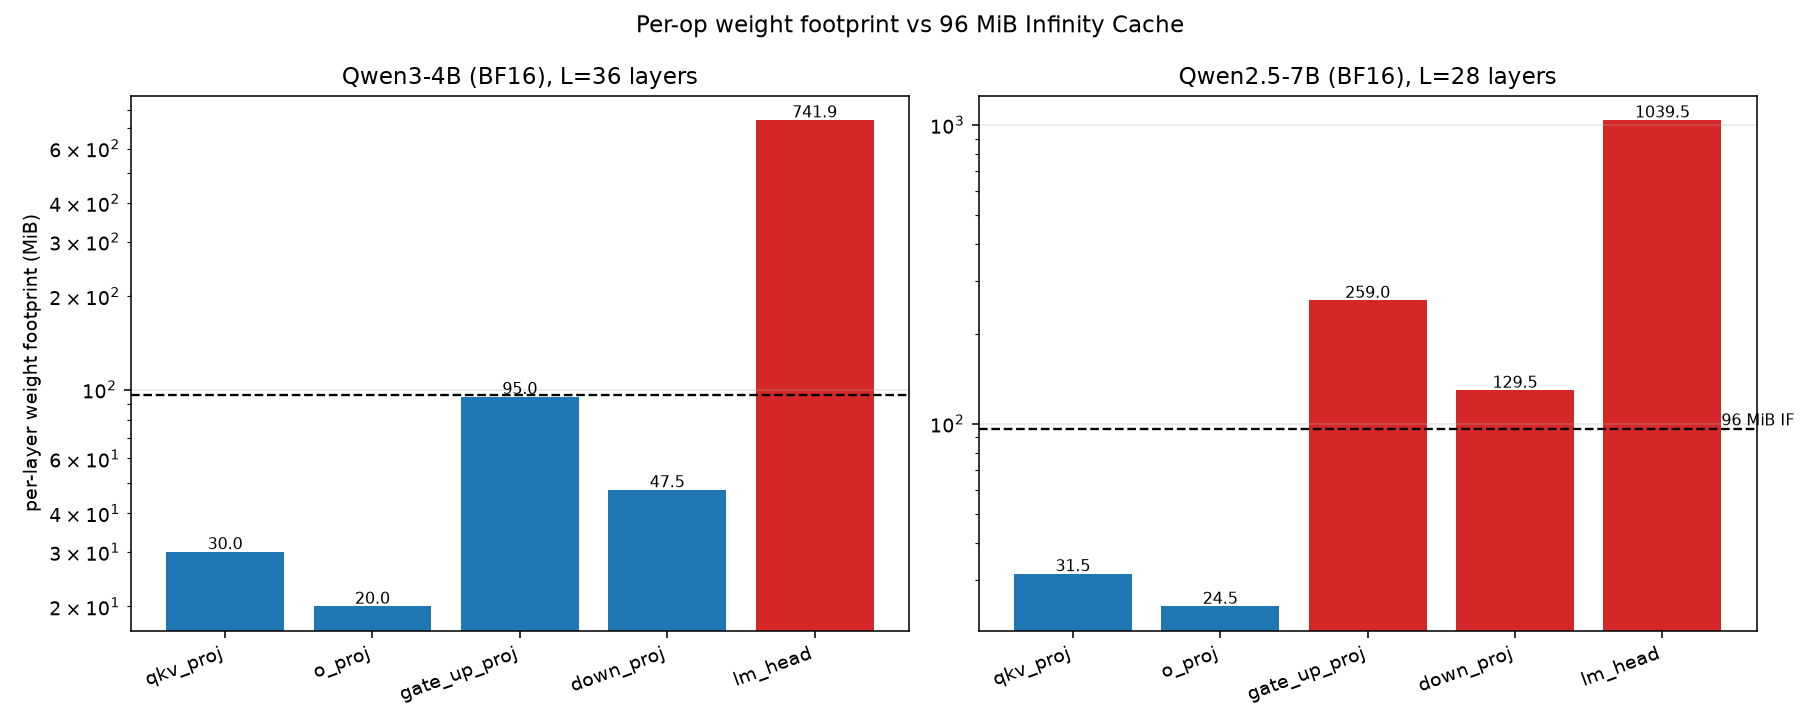
这就把问题回答清楚了:
- 4B:qkv / o / gate_up / down 四个主干算子的权重单独都能放进 96 MiB(BF16 的 gate_up 95.0 MiB 正好贴上限,Q4 下更是远远够用)。所以 4B 的 decode 权重访存大量命中 IF,测到的是 IF 路径带宽。
- 7B:只有 qkv(31.5) / o(24.5) 放得下;gate_up(259) / down(129.5) / lm_head(1039.5) 全部放不下,是纯 HBM。7B 的 decode 权重流量是 IF 与 HBM 混合的。
- 但”层”放不进:单层四主干合计 4B 192.5 MiB、7B 444.5 MiB,任何一层都超 96 MiB。所以 IF 的收益只在算子粒度成立,到层粒度就被打散了。
这解释了一个之前被含糊带过的现象:为什么 4B 的”等效带宽”只有 491–699 GB/s,明明它的算子全都放得进 IF? 因为瓶颈根本不是带宽——是并行度(4B 太小喂不满 48 CU)和 kernel 效率。用小模型测”这张卡能跑多快”会系统性低估 HBM;同样,小模型也不能拿来测”IF 有多快”。
六、模型级:llama.cpp 下的五档精度
先给一张全局对照图——把所有模型级路径的算存比和各自的 ridge 摆在一起(蓝 = llama.cpp 端到端,红 = vLLM batch=1,绿 = vLLM batch=8,叉号 = 理论 ridge):
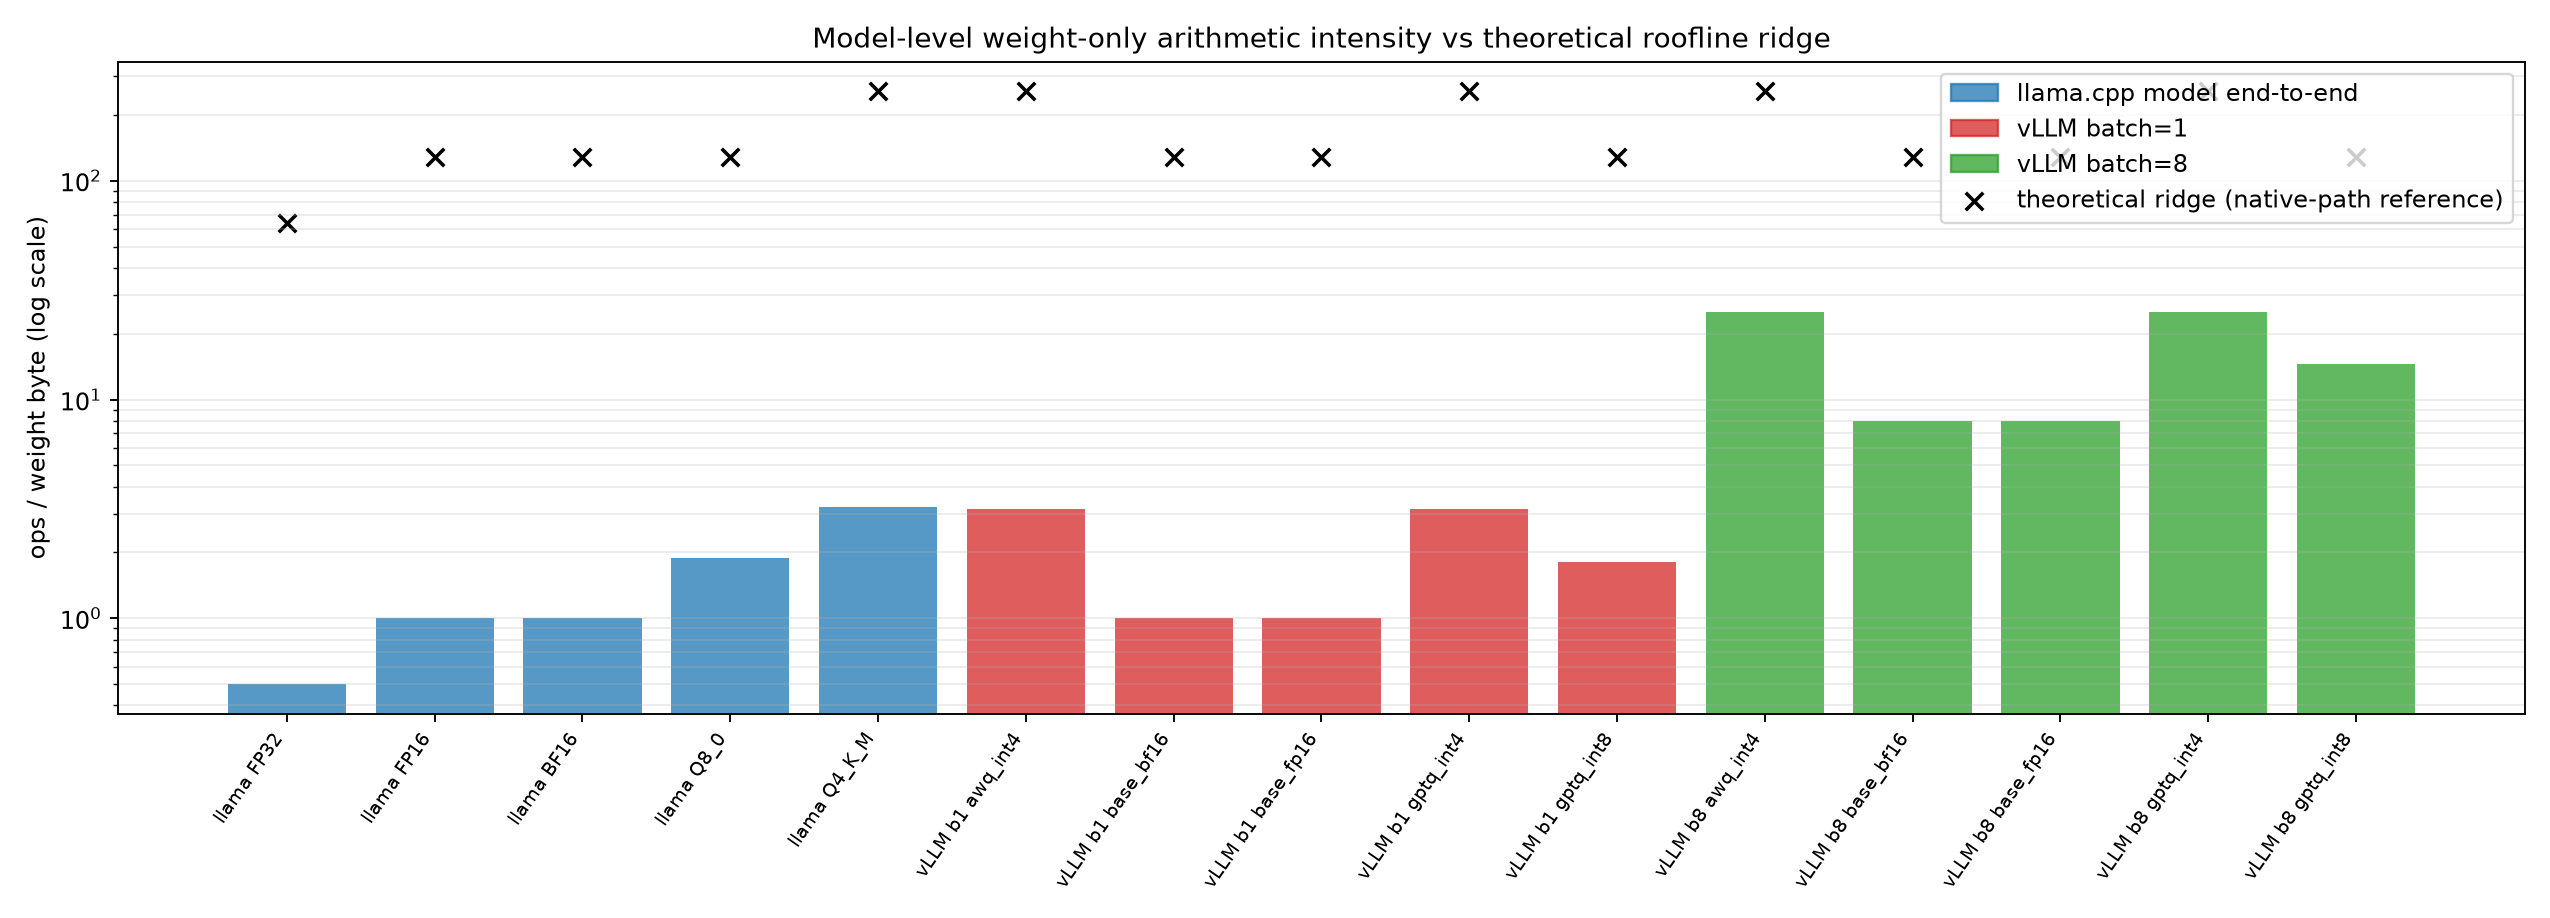
它已经把全篇的骨架画出来了:所有实测柱子都远低于叉号,且越靠右(精度越低)算存比越高。 下面逐档展开。先把整个 7B 模型端到端跑起来,decode 阶段的中位数(每 token 权重字节 × tok/s = 等效读带宽):
| 精度 | 文件 | 每 token 权重 | bit/逻辑参数 | 权重 AI | decode tok/s | 等效读带宽 |
|---|---|---|---|---|---|---|
| FP32 | 29057 MiB | 26972 MiB | 32.00 | 0.500 | 失败(超显存) | — |
| FP16 | 14532 MiB | 13487 MiB | 16.00 | 1.000 | 56.40 | 797.6 GB/s |
| BF16 | 14532 MiB | 13487 MiB | 16.00 | 1.000 | 56.07 | 793.0 GB/s |
| Q8_0 | 7723 MiB | 7165 MiB | 8.50 | 1.882 | 93.00 | 698.8 GB/s |
| Q4_K_M | 4466 MiB | 4168 MiB | 4.95 | 3.235 | 128.90 | 563.4 GB/s |
几个值得注意的点:
- FP16 的算存比恰好是 1.000,这不是巧合。对权重流主导的 decode:
AI = 2 × params / (params × bytes_per_param) = 2 / bytes_per_param。FP16 每参数 2 字节,于是AI = 2/2 = 1。FP32 是 0.5,Q8_0 是 1.88,Q4_K_M 是 3.24——算存比只由”每个参数占多少位”决定。 - FP16 单请求就把带宽利用率干到了 91%(797.6 / 874.2),84%(797.6 / 960)。7B 的 FP16 权重总量 ~14 GiB,远大于 96 MiB IF,所以这个 797.6 GB/s 作为端到端等效值是 HBM 主导的,可以信。但要标注一句:端到端里 qkv / o 这类小算子会命中 IF,这个数字已经被 IF 悄悄抬高过一小截,它不是纯 HBM 流量。真正”纯 HBM”的证据是 §四里 >112 MiB 工作集的 874 GB/s。
- 量化确实提升了算存比,但吞吐不一定同步涨:Q8_0 的 AI 是 FP16 的 1.88 倍,吞吐只涨到 1.65 倍;Q4_K_M 的 AI 是 3.24 倍,吞吐 2.29 倍。多出来的开销都被反量化吃掉了——AI 是理论账,kernel 才是现实。
七、模型级:vLLM 下的 batch=1 / batch=8
换到 vLLM(7B,input 512 / output 128):
| 路径 | batch=1 tok/s | batch=1 AI | batch=8 tok/s | batch=8 AI |
|---|---|---|---|---|
| BF16 | 58.82 | 1.000 | 288.17 | 8.000 |
| FP16 | 58.88 | 1.000 | 317.25 | 8.000 |
| GPTQ-INT4 | 94.12 | 3.153 | 485.80 | 25.221 |
| AWQ-INT4 | 55.55 | 3.156 | 337.24 | 25.247 |
| GPTQ-INT8 | 11.76 | 1.819 | 75.77 | 14.553 |
这里有全篇最”违背直觉”的一组对照:GPTQ-INT4 和 AWQ-INT4 的算存比几乎一模一样(3.153 vs 3.156),吞吐却差 1.7 倍(94.12 vs 55.55 tok/s)。 原因不在数学,在 kernel:
- GPTQ 走的是 ROCm 上融合的 W4A16 kernel,反量化融进 GEMM 流水;
- AWQ 在 ROCm 上退回了整块反量化的 Triton 路径,权重先还原成 FP16 再乘。
同样的 4 bit、同样的带宽需求,不同的反量化实现能拉开 70% 的差距。这也是为什么”量化后一定更快”是一个需要用数据检验的假设,而不是定理。
八、并发:N=1→16 的访存比
把 batch 从 1 扫到 16,观察算存比和吞吐怎么走:
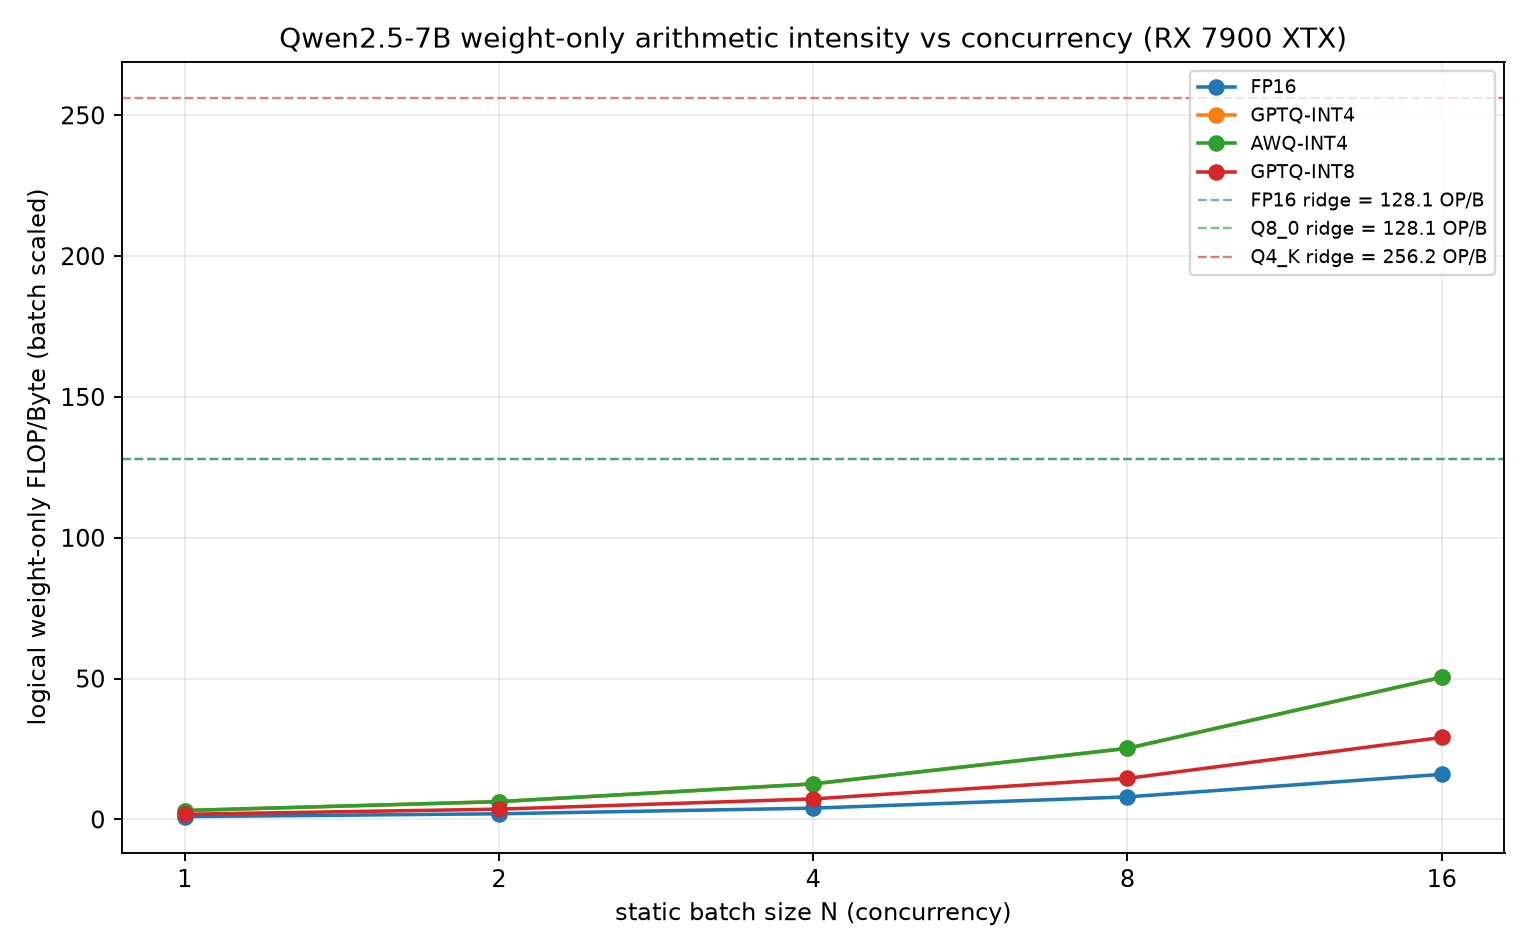
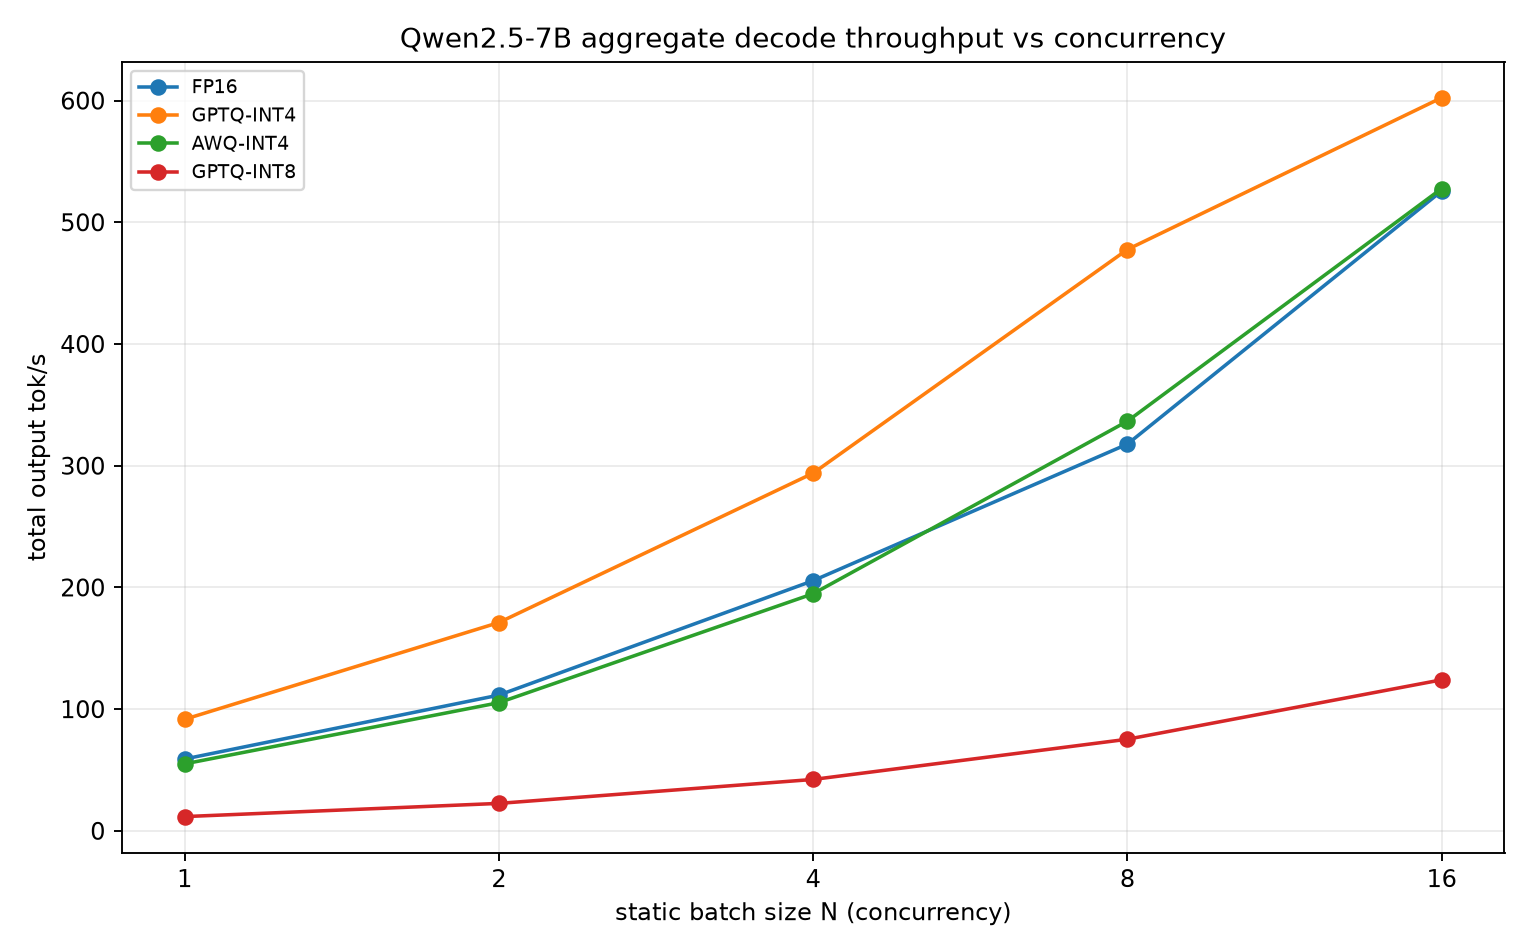
N=16 时的明细:
| 路径 | N=16 AI | 占 ridge(HBM 下界) | 占 ridge(IF 上界) | 聚合 tok/s | N=16 等效带宽 | batch 效率 vs N=1 |
|---|---|---|---|---|---|---|
| FP16 | 16.00 | 12.5% | 26.0% | 525.7 | 465 GB/s | 0.56 |
| GPTQ-INT4 | 50.44 | 19.7% | 41.0% | 602.4 | 169 GB/s | 0.41 |
| AWQ-INT4 | 50.49 | 19.7% | 41.0% | 527.7 | 148 GB/s | 0.60 |
| GPTQ-INT8 | 29.11 | 22.7% | 47.3% | 124.1 | 60 GB/s | 0.66 |
三个观察:
- 并发把 AI 线性拉高(权重被批量共享),但到 N=16 也够不到 ridge。这里的”占 ridge”必须给区间:按 HBM 960 GB/s 当带宽屋顶,只到 12.5%~22.7%;若假设算子权重全命中 IF(
2 TB/s,ridge 相应更低),上界抬到 **26%47%**。给单个数字(无论 12% 还是 47%)都是错的,因为 7B 的权重流量在 IF 与 HBM 之间是混合的。 - batch 效率从 N=8 开始明显塌方(N=8→16 的效率掉到 0.41~0.66)。权重共享的收益被 attention/KV、调度和固定开销吃掉了。
- 等效带宽随 N 增大反而下降:FP16 从 N=1 的 835 GB/s 掉到 N=16 的 465 GB/s。因为权重读一次就够,N 越大,单位 token 分摊到的权重读越少——“带宽”这个指标在 batch 化之后就不再是瓶颈的主语了。补充的 kernel 扫描也印证了这点:n=16 时 f16/q8_0/q4_K 的权重带宽整体更低更平(f16 峰值从 n=1 的 1617 掉到 979),说明 N=16 的算子已经转向计算受限,拿带宽 ridge 去衡量它本身就是错的标尺。
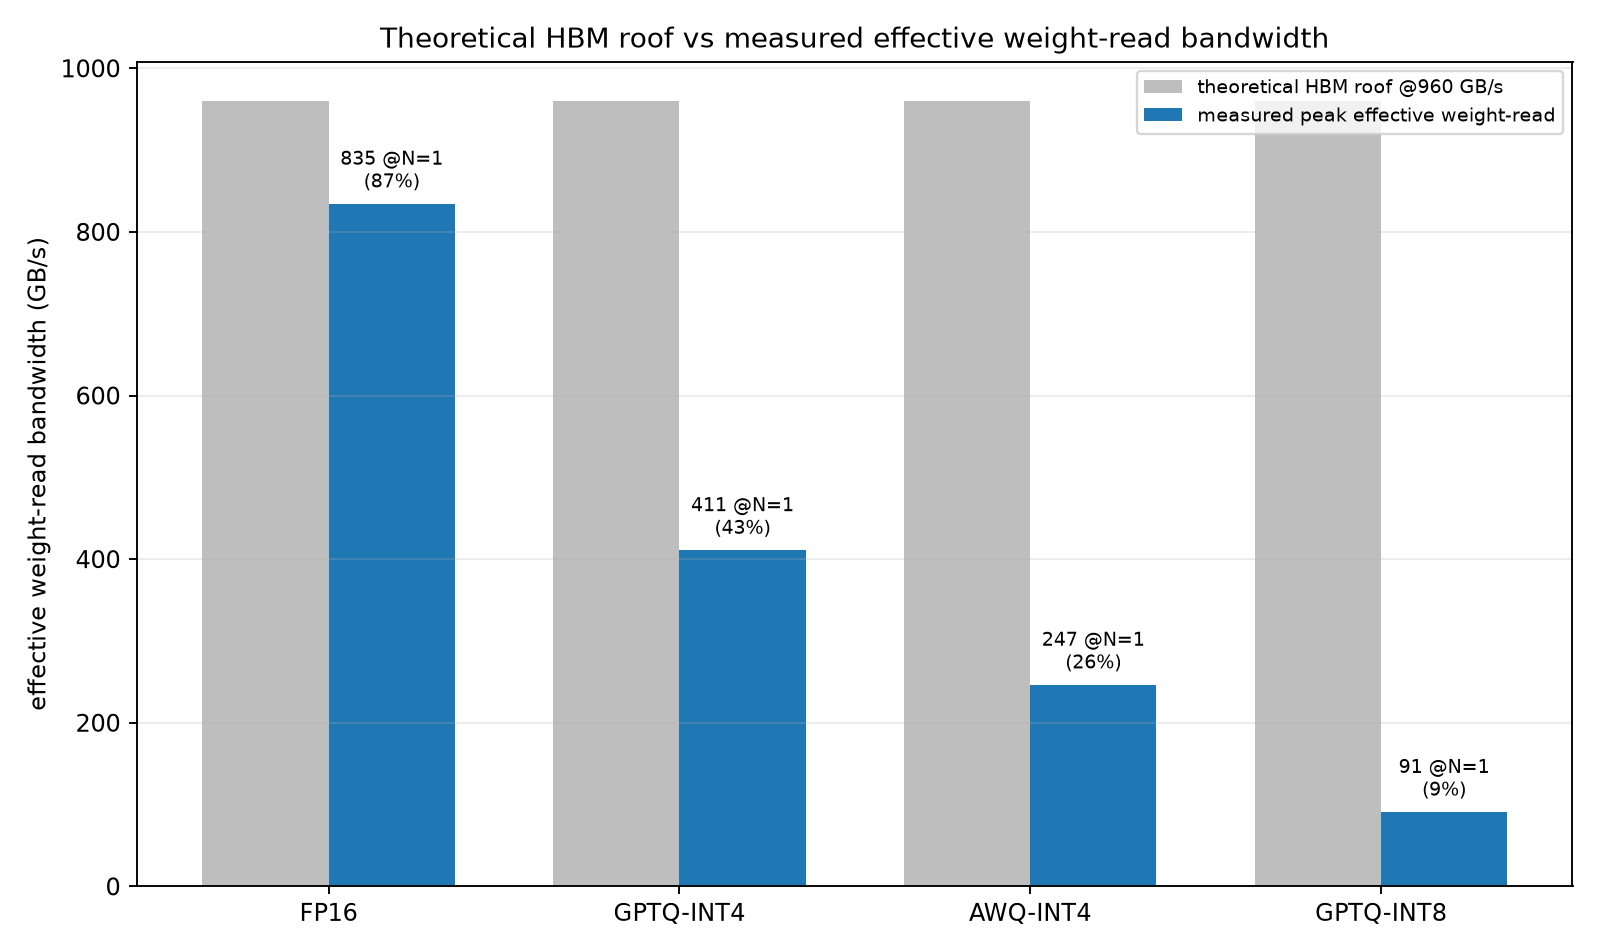
第 3 张图(理论屋顶 vs 实测等效带宽)最直白:FP16 能摸到屋顶的 87%,GPTQ-INT4 只有 43%,AWQ 26%,GPTQ-INT8 9%。精度越低,等效带宽越”低”——不是硬件变弱了,而是每 token 要搬的权重字节少了,同样的绝对带宽能撑起更多 token。
九、跨尺寸:0.5B / 4B / 7B,模型是不是太小了?
这才是这次实验的起点。最初的怀疑是:用小模型测这张卡,是不是根本测不出它的带宽?
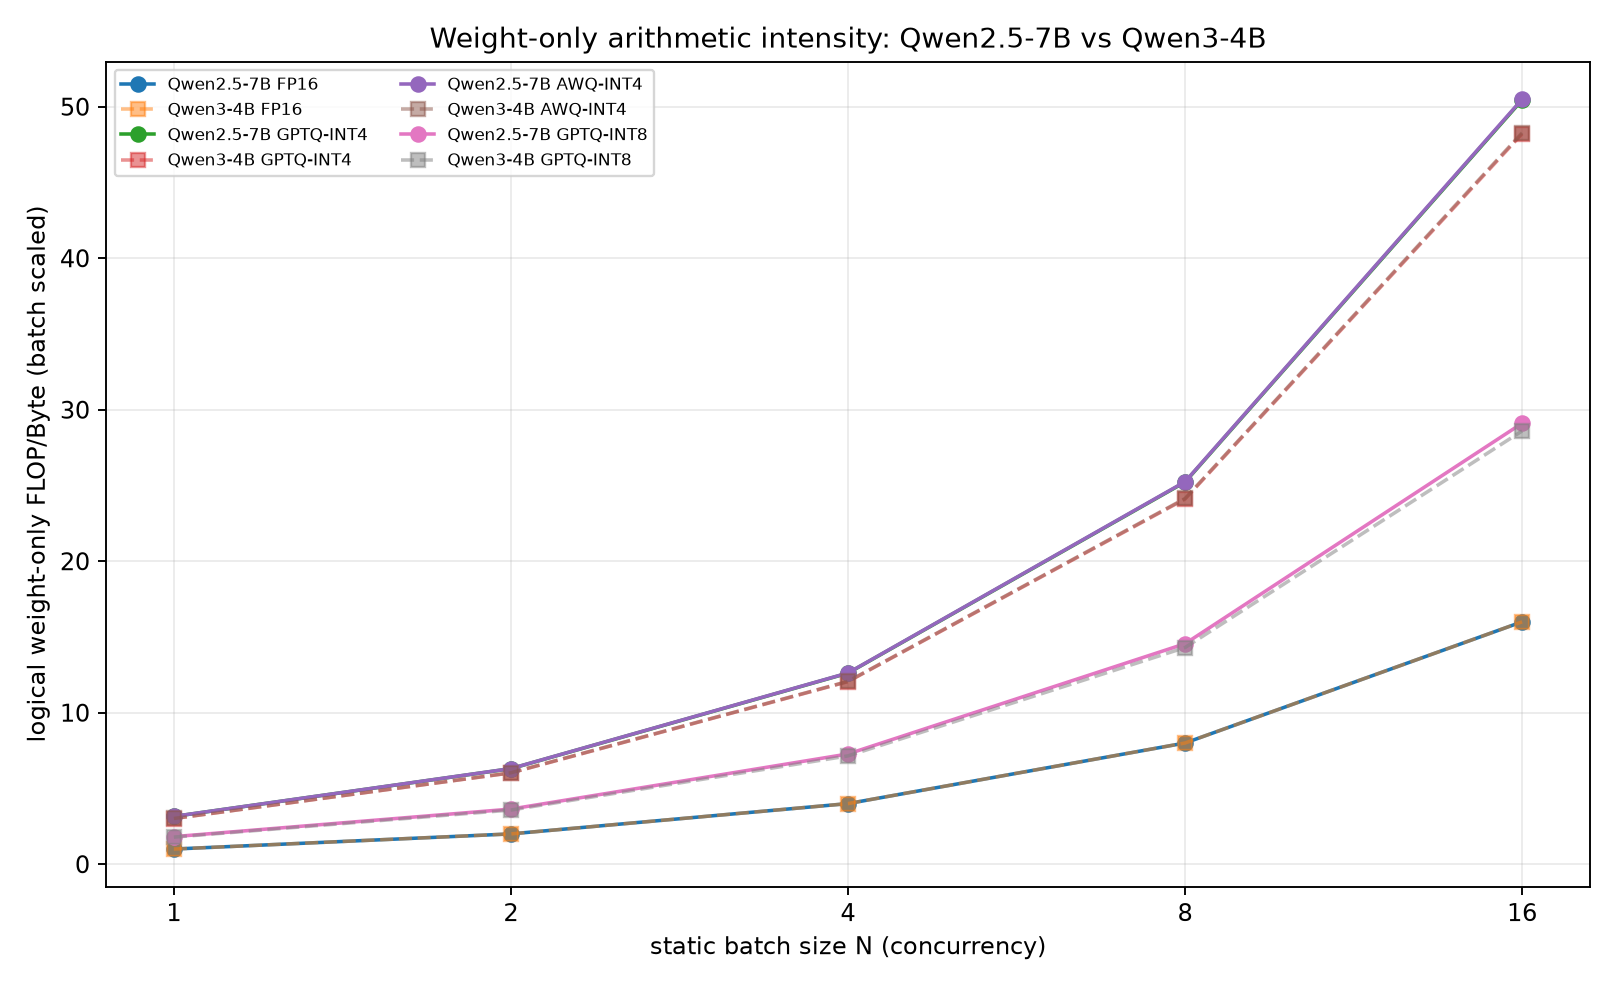
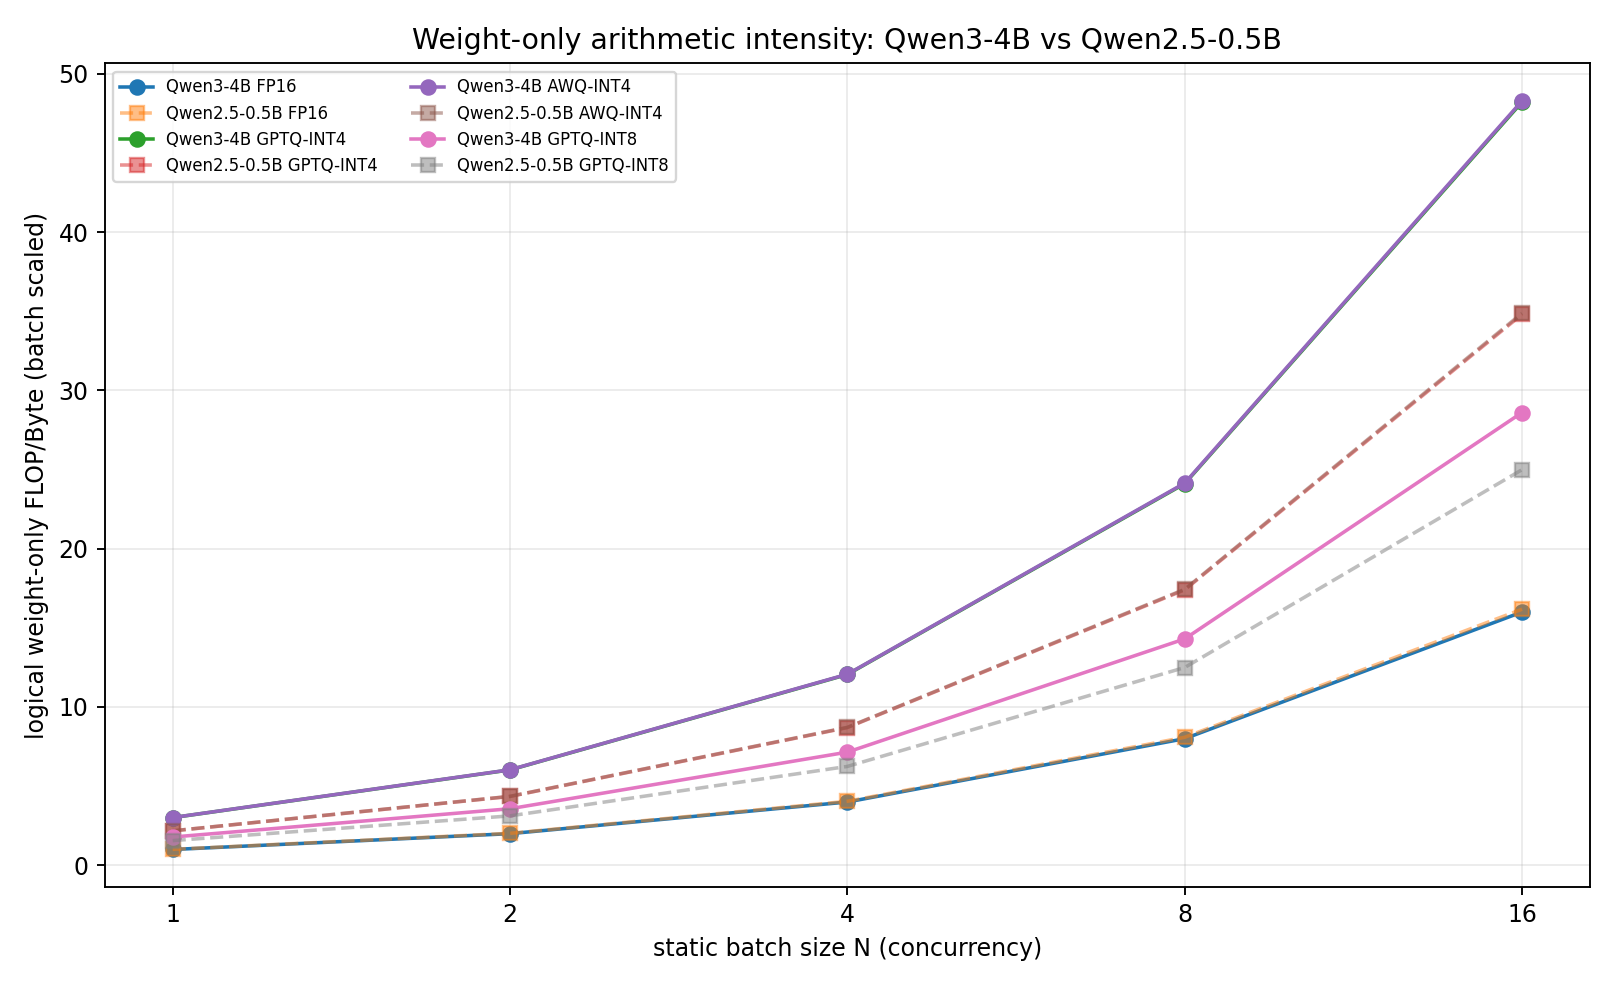
把三个尺寸放在同一把尺子下(vLLM FP16,N=1):
| 尺寸 | 每 token 权重 | N=1 等效读带宽 | N=16 聚合 tok/s |
|---|---|---|---|
| Qwen2.5-0.5B | 0.92 GiB | 90.8 GB/s | 1061 |
| Qwen3-4B | 7.49 GiB | 491.4 GB/s | 560 |
| Qwen2.5-7B | 13.17 GiB | 834.6 GB/s | 526 |
三个结论,方向不同但都成立:
结论一:模型确实不能太小。 0.5B 的等效带宽只有 90.8 GB/s——连这张卡读带宽的 11% 都摸不到。小模型里,kernel 启动、logits、attention、采样、KV 这些固定开销占比过高,权重还没喂饱卡,别的开销先到顶了。4B 提升到 491 GB/s(明显偏小),7B 才到 834 GB/s(进入权重流主导区)。“用小模型测带宽”在这张卡上是行不通的。
结论二:算存比本身不随模型变大而升高。 看两张图——不同尺寸的曲线几乎完全重合。这不是数据出错,而是数学必然:AI = 2 / bytes_per_param,分子分母同比例增长,模型尺寸被约掉了。FP16 在任何尺寸下算存比都是 1.0。
结论三:小模型”测不出带宽”还有一层 IF 解释。 0.5B / 4B 的算子权重小到能整块驻留 IF(见 §5.3),它们本该享受到 IF 的 ~2 TB/s,实测却只有 90.8 / 491.4 GB/s。所以这不是”HBM 不够快”,而是并行度不足 + kernel 效率低:权重喂不满 48 个 CU,IF 的高带宽根本发挥不出来。拿 HBM 峰值去衡量小模型,方向就错了;真正卡住小模型的是并行度与固定开销,不是显存带宽。
所以真正随模型变大而改善的,是带宽利用率(从 11% → 56% → 87%),而不是算存比。也正因为如此,大模型的绝对吞吐反而更低(7B N=16 ≈ 526 tok/s,只有 0.5B 的一半)——单位算力要喂的字节更多了。
一句话记法:想让 GPU”进入 roofline 的带宽分支”是大模型的事;想让吞吐绝对值高是小模型的事。 这两件事用的是不同的杠杆。
十、两个”如实失败”的样本
实验里有两条路径压根跑不起来,它们同样是结论:
FP32 在 7B 上必然 OOM。 7B 的 FP32 权重是 28.28 GB(GGUF 文件 30.47 GB),直接超过 24 GiB 显存。llama.cpp 与 vLLM 全部在加载阶段失败。在消费级 24G 卡上,FP32 7B 不是一个可选档位。
FP8 在 gfx1100 上无路可走。 vLLM 的 FP8-dynamic 在加载期调用 torch._scaled_mm,直接报错:该算子只支持 CUDA SM 8.9/9.0 或 ROCm MI300+。RDNA3 没有原生 FP8 matrix 单元,也没有可用的软件 fallback。7900 XTX 想跑 FP8,现阶段没有可用的高效路径。
这两条我不会填任何编造的实测数字——失败就是失败,记下来比凑一个好看的数字有用。
十一、结论
把上面所有东西收束成几句话:
- decode 天然带宽受限。 单请求权重 AI 只有 0.50~3.24,离理论 ridge(64/128/256)差一到两个数量级。这不是引擎没调好,是 batch=1 的数学必然。
- 7B 是让这张卡”吃饱”的合适量级——但要分清它吃饱的是哪一档带宽。 FP16 单请求端到端等效读带宽 797.6 GB/s = 实测 HBM 读带宽的 91% / 官方 960 GB/s 的 84%,这是 HBM 主导的结论。同时 7900 XTX 的带宽屋顶其实有两档:工作集 ≤ 96 MiB 时是 IF 的 ~2 TB/s,超出后才是 HBM 的 ~874 GB/s;单算子(尤其 4B / Q8_0)经常落在 IF 那一档。0.5B 完全测不出带宽,4B 偏小——它们卡在并行度和 kernel 效率,不是 HBM 不够快。
- 算存比与模型尺寸无关,只与每参数位数有关。
AI = 2 / bytes_per_param。变大的是带宽利用率。 - 量化提升算存比,但收益要 kernel 兑现。 同为 4 bit,GPTQ(融合 W4A16)比 AWQ(Triton 反量化)快 70%。
- 并发能拉高算存比,但 N=16 仍然够不到 ridge。 按 HBM 下界算是 12.5%
22.7%,按 IF 上界算是 26%47%——这个区间本身就是”IF 与 HBM 混合”的体现。而且 N=16 的算子已转向计算受限(kernel 扫描里 n=16 的权重带宽整体更低更平),带宽 ridge 不再是衡量它的好标尺。batch 效率也已从 0.41~0.66 一路下滑。 - FP32 7B 必然 OOM;FP8 在 gfx1100 无可用路径。 两个档位在 7900 XTX 上直接划掉。
- 带宽必须给两档口径。 96 MiB Infinity Cache 不是”大一点的 L2”,而是一条独立的高带宽层:≤96 MiB 是 ~2 TB/s(IF ridge = 算力 ÷ 2 TB/s),超出后是 ~874 GB/s(HBM ridge = 算力 ÷ 960 GB/s)。任何”等效带宽”在引用前都要说清测的是哪一档——在 96 MiB 这个容量点附近,换口径会带来 2 倍以上的结论差。
最后补两句方法论上的克制:本文所有”带宽”都是等效口径(吞吐反推),没有采集硬件 DRAM 计数器;并且由于本机 rocprofv3 的 GL2C 块计数器恒返回 0,“IF 命中率”同样没有直读——IF 的结论全部由”跨 96 MiB 的带宽断崖”这一直接观测量推出。如果您要引用这里的数字,请连同这个口径一起引用——把等效带宽说成”实测显存流量”是这类分析里最常见、也最误导的错误。
十二、复现
三组实验(0.5B / 4B / 7B)各自独立成目录,包含:
- 原始结果:
results/{llamacpp,vllm,vllm_batch1,vllm_concurrency}/*.json - 汇总表:
results/common/*.csv - 可视化:
results/**/figures/*.png - 脚本:
scripts/(HBM microbench、引擎跑分、分析与一致性校验)
分析链路(HBM microbench → 模型级分析 → 并发分析 → 数值一致性校验)全部可一键复跑,报告里的每一个数字都与 CSV 逐项对齐。若您在自己的卡上复现,唯一需要改的就是峰值算力与标称带宽这两个常量,其余口径完全通用。
IF Cache 补实验单独成目录 experiments/ifcache_arith_7900xtx_20260924/:工作集扫描(实验 A)、llama.cpp 真实 MUL_MAT 权重体量扫描(实验 B)、算子 footprint 映射(实验 C),外加完整报告 REPORT.md 与三张图。§四的断点表、§5.2 的 kernel 扫描、§5.3 的 footprint 表全部出自这里。硬件局限已如实记录:本机 rocprofv3 的 GL2C 块计数器恒返回 0、perf_event_paranoid=4 且无免密 root,因此 IF 命中率是推断而非直读,所有 IF 结论都建立在”跨 96 MiB 的带宽断崖”这一直接观测量上。